MTP是现在开源模型 deepseek, qwen 都装载必备模型结构。作为一个经典的技术,其对模型的推理效果(答案质量)和推理速度都有很好的收益。无论是了解模型结构,还是做推理加速,MTP都是一个绕不开的话题。 本文会从MTP诞生的前置方法Medusa开始讲解,介绍meta发明MTP的动机和理论知识,并延伸介绍deepseek 改版的MTP。为读者理清MTP的前世今生。欢迎大家共同讨论学习。
Medusa
想要清楚MTP的细节,有必要先了解一下Medusa https://arxiv.org/pdf/2401.10774。 这个方法2023年被提出。参与人有Tri Dao (FlashAttention 作者)
传统的投机推理的一个不足之处是依赖一个小的草稿模型生成token需要单独训练和维护,增加了额外的计算开销。尤其是世界上不存在两个相同的模型。因此草稿模型和目标模型之间总是存在概率分布的差异。
区别于投机推理中大小模型的组织形式。 Medusa 放弃使用草稿模型,选择直接在目标模型上做文章。
MEDUSA 的核心思想是通过在原有 LLM 的最后隐层之上添加多个额外的解码头。这个方法引入了树形注意力机制使得模型可以并行预测。这一方法很重要后面会详细介绍。
下面是Medua论文的一个代表图片
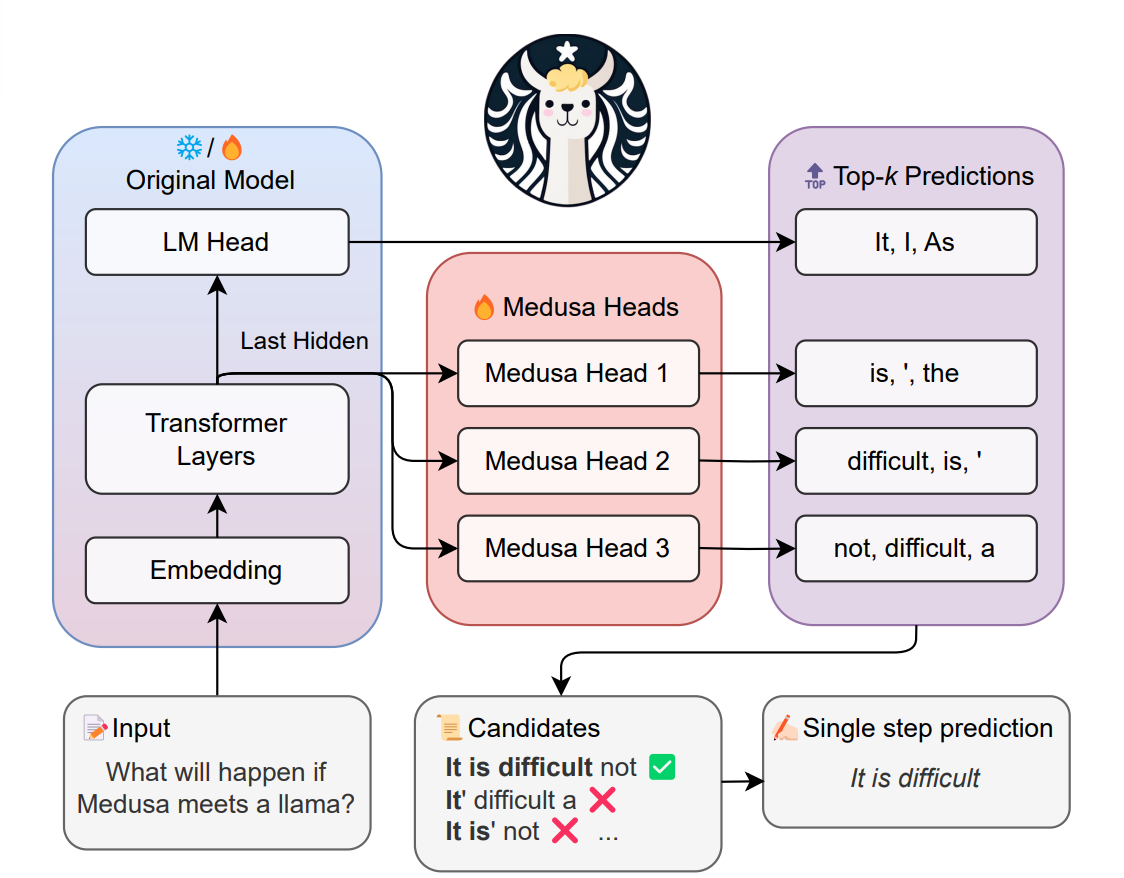
下面解释这个图片的含义
通常大模型在输出词表的每一个单词的概率时,要使用LM head层。这一层是计算概率分布之前的最后一步线性映射。他的输出是为归一化的原始得分, 得分经过logits 上应用的softmax 在词表范围上映射为和为1的概率。
原本Lm head的输入是模型最后一层隐藏层特征,Medusa的创新之处在于让最后一层隐藏层特征的接入不止lmhead。还加上自己的多个head 。 使得 原本Lm head预测的是输入ht特征时,第t+1个token 。 加上的medua head 第一个medusa head 预测 第t+2个token, 第2个medusa head预测第t+3个token。 这样来看其名为美杜莎非常形象。
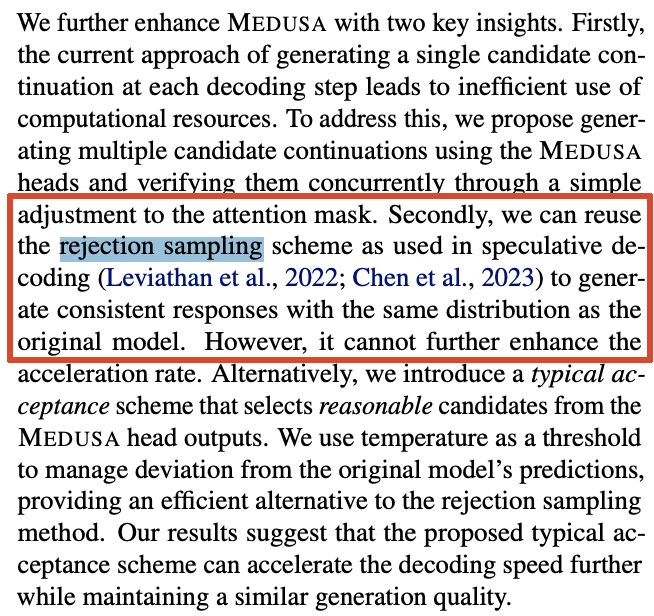
通过这样的方式,代替了原本草稿模型提前推理的特性。得到的答案再按照投机解码中,拒绝采样的方式进行概率分布的接受,拒绝和重采样,实现推理加速(从零理解 Speculative Decoding:原理、拒绝采样与技术演进)。
树形注意力机制
树形注意力机制非常重要,作为medusa最重要的贡献,几乎后来所有的主流投机推理方式都采纳了这一方法。
树形注意力机制将多个 Medusa Head 预测出的词汇组合成一棵候选树,允许大模型在单次前向传播中,并行处理和验证这棵树上的所有候选分支。
在传统的文本生成中,模型每次只猜测一个 Token,因此一次前向传播只需要计算一条路径。
但在 Medusa 中,模型外挂了多个 Head。假设原版 lm_head 和新增的 2 个 Medusa heads 各自都给出了 Top-2 的候选词,那么组合起来就会形成一个庞大的“候选序列”网络(例如 ($2 \times 2 \times 2 = 8$ 种潜在的后续句子组合)。
为了验证这八种组合,最笨的方法是让模型执行八次独立的计算。 但是这样会消耗算力和内存。因此medusa设计了一种并行验证这八种组合的方式。
Medusa 将多个 Head 预测出的候选词,通过笛卡尔积组合成一个多层级的树状结构。下图是Medusa文章的原图,左半部分就是一颗放到的树,树的根节点是当前的 Prompt, 第一层的孩子节点是第一个head预测topk的词,在这个图中k为2, 第二层孩子节点是第二个head预测出的top3的词
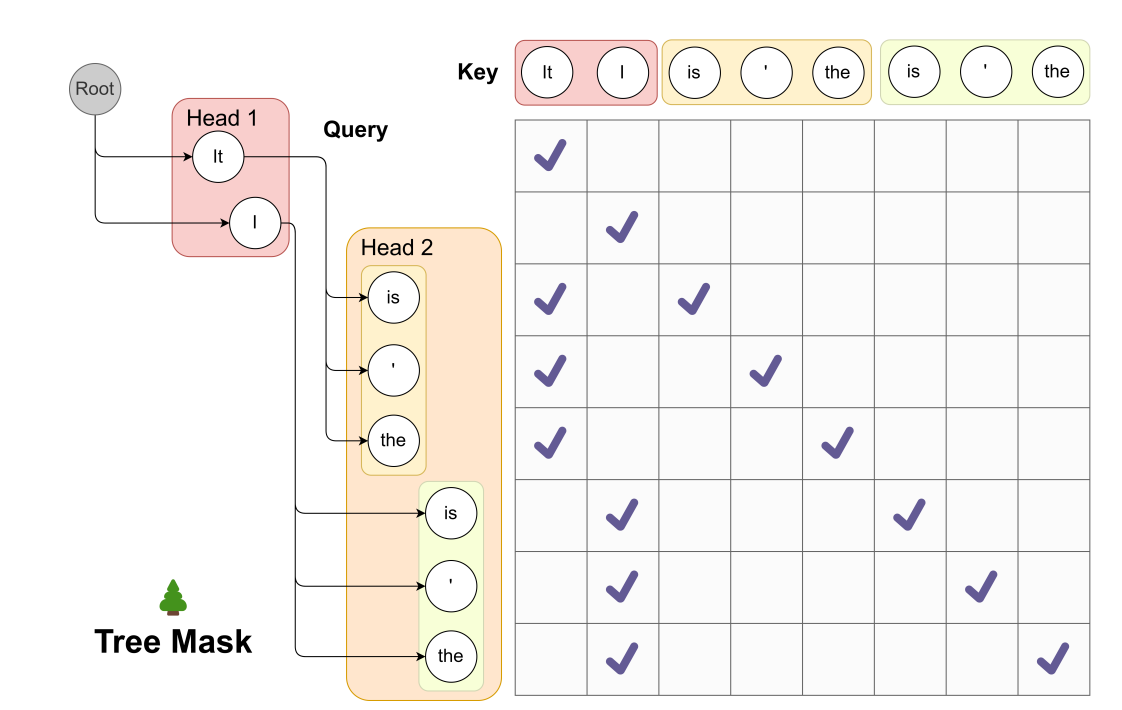
右侧矩阵将左侧树结构中的所有节点展平排开。矩阵中打勾的格子代表允许该 Query 词去“看”该 Key 词;空白的格子则代表被 Mask掉,无法看到。
以第 3 行举例(黄框的 is): 它属于 It这条分支。在右侧矩阵中,这一行只在第 1 列的 It和第 3 列的自己(is)打了勾。这说明,在计算注意力时,它只能读取自己所在路径的历史,绝对看不到第 2 列平行的 “I”。 这代表了第+1个token预测 It, 第+2个token预测is 这种组合。
第 6 行(绿框的 is): 它属于 I这条分支。矩阵中,它只在第 2 列的 I和第 6 列的自己打了勾,同样完美避开了 It 分支的干扰。
通过这张图可以看出,大模型在验证时,不需要一条路径一条路径地跑前向传播。它直接把这 8 个词打包成一个序列输入,然后把这张打好勾的二维矩阵作为 Attention Mask 喂给模型。这样,所有候选组合的概率验证就能在一次前向传播中完全并行地计算完毕
训练方式
MEDUSA-1:冻结原始模型,只训练 MEDUSA 解码头。这种方法参数效率高,可以利用量化技术进一步降低内存消耗,而且不会影响原始模型的生成质量。
MEDUSA-2:同时微调原始模型和 MEDUSA 解码头。这种方法可以提升 MEDUSA 解码头的预测准确性,从而获得更高的加速比,但需要特殊的训练技巧来保持模型的原有能力
最后值得一提的是原本模型的 lm_head 层依然是整个推理过程的核心,它并没有脱离推理,而是同时承担了“直接预测”与“最终验证”的双重角色。
原始的 lm_head 依然负责预测紧接着的下一个 Token。如果 Medusa heads 猜测的后续多条路径全部错得离谱、被系统全部拒绝,模型就会直接使用原始 lm_head 给出的预测结果作为输出,保证生成过程不会中断。
当包含众多猜测的候选树被一次性输入模型进行前向传播时,原始的 lm_head 负责计算出树中每一个节点在真实语境下的真实概率分布来决定接受还是拒绝这些猜测。由于这里用的是拒绝采样,拒绝时可以获得clean token。具体可见原文明确使用的拒绝采样。Medusa对拒绝采样有一点修改,基于温度,在本文中不详细介绍了。
Meta-Multi-token Prediction
Meta团队于202404 发表的论文Better & Faster Large Language Models via Multi-token Prediction https://arxiv.org/pdf/2404.19737
这篇文章 将 Medusa 用于大模型推理加速的结构,前置并整合到了“预训练”阶段。
该团队发现在预训练阶段引入多 Token 预测,会使额外的预测头的准确率远超对已有模型进行简单微调并外挂预测头的做法。
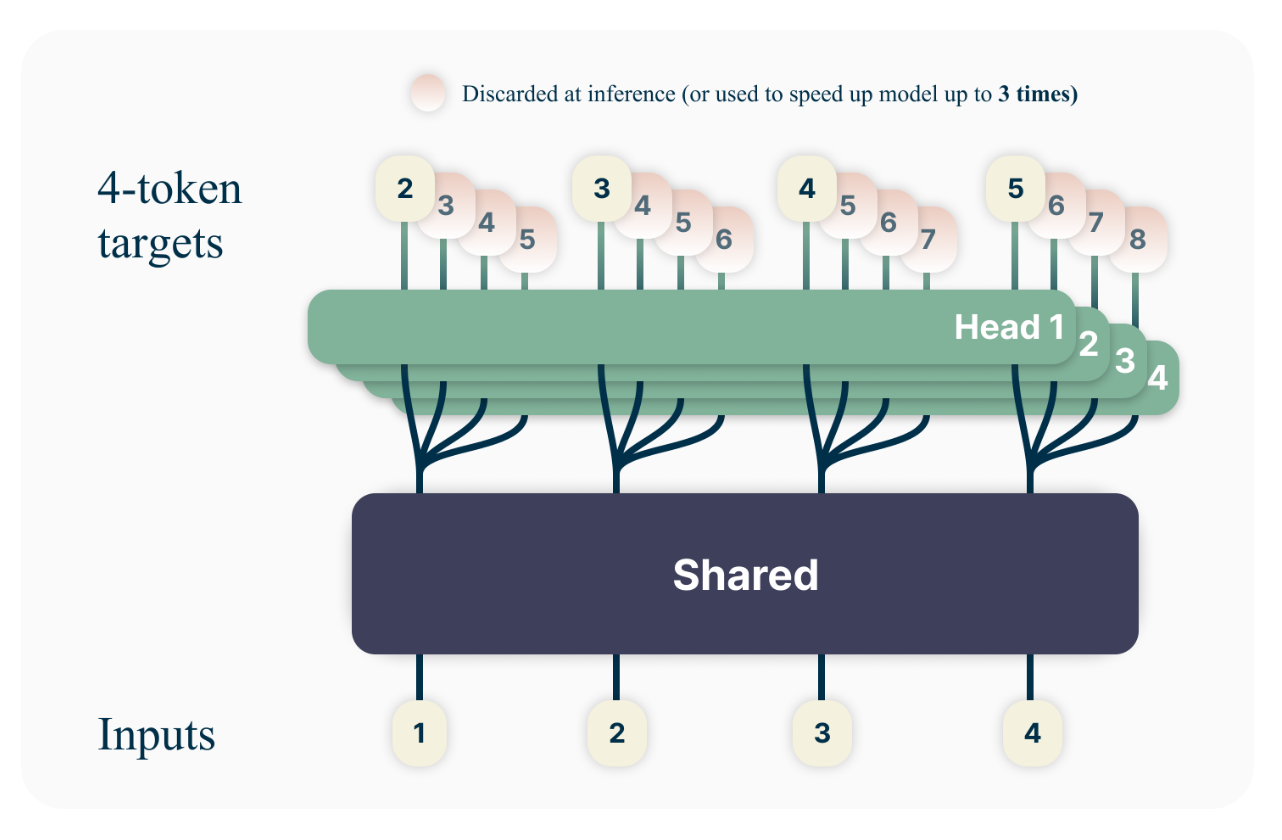
与Medusa的思路相同,所有的预测头共享模型主干。这些输出头并行工作,预测对应的未来token。
这样的结构经过实验发现会使得模型推理时有更好的推理结果。 并且多头的存在天然构成了投机的预测效果。达成推理又好又快的效果。像上面这个图其实是一种MTP-3的结构原始。我们可以通过看这个更细粒度图对比
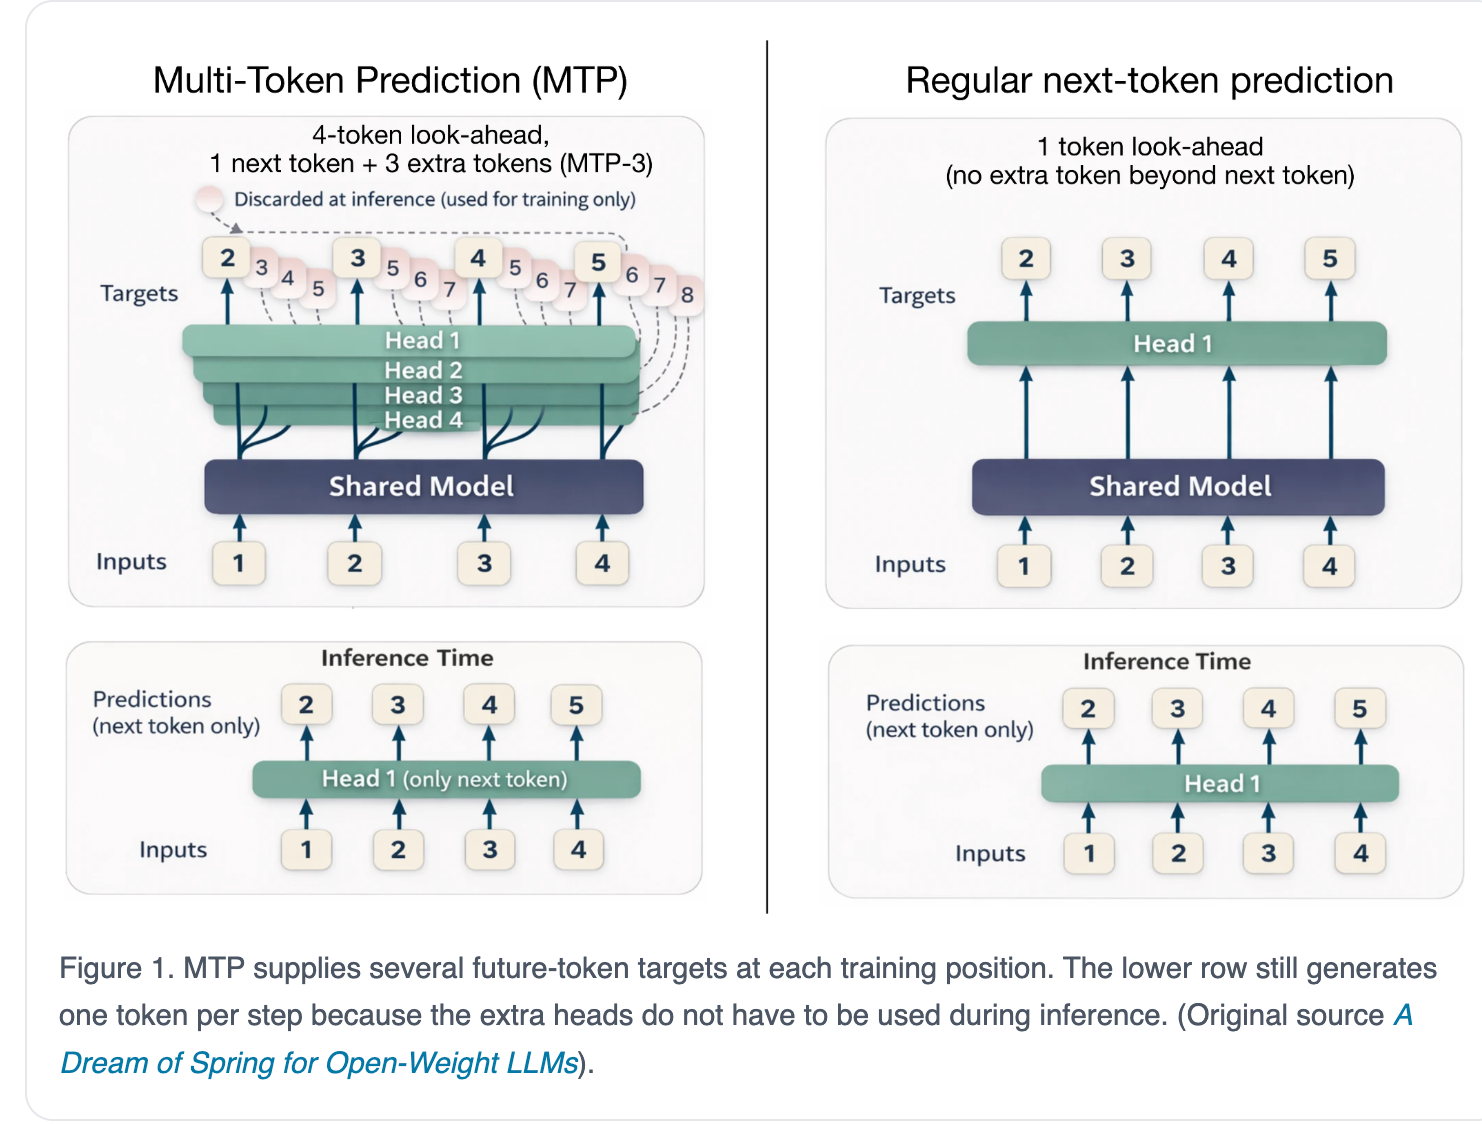
为什么多token预测可以提高模型的样本效率?
更强的监督信号:通过预测多个token,模型可以获得更丰富的监督信号,从而更快地学习到语言的结构和规律。
关注重要决策点:多token预测可以促使模型关注那些对后续文本生成有重要影响的「决策点」,而不是只关注局部模式。
学习长距离依赖:多token预测可以帮助模型学习token之间的长距离依赖关系,从而更好地理解上下文信息。
并行计算:多token预测允许并行预测多个token,从而提高训练效率,使得模型在有限的训练数据上能学习到更多的信息。
DeepSeek-V3的MTP
DeepSeek-V3 借鉴了 Meta FAIR 团队论文 Better & Faster Large Language Models via Multi-token Prediction 中的思路,但在实现上有明显不同:它并不是直接并行预测多个 token,而是保持完整的因果链,以逐层递进的方式预测未来 token。这个所谓的因果链其实非常简单,这个意思是说预测下一个 token 时依赖前一层预测结果,这个结果通常以LM head 前最后一层隐藏层特征形式传递给下一个head 最为输入
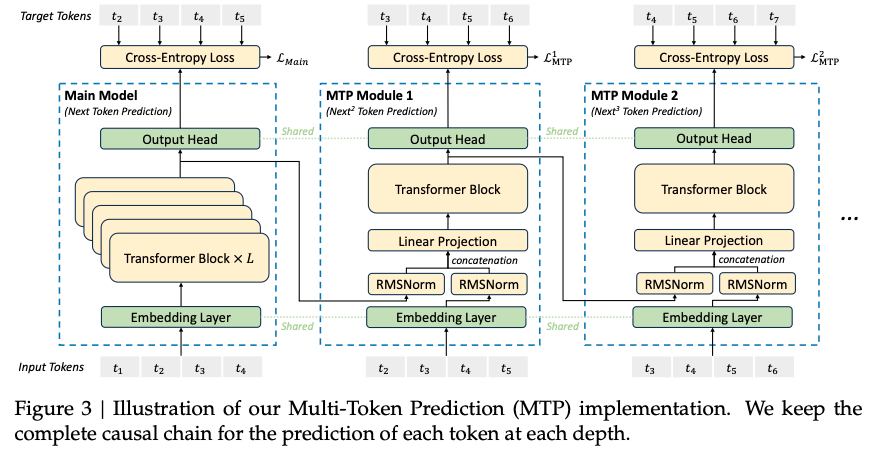
再看一个实际推理的参考图加深理解
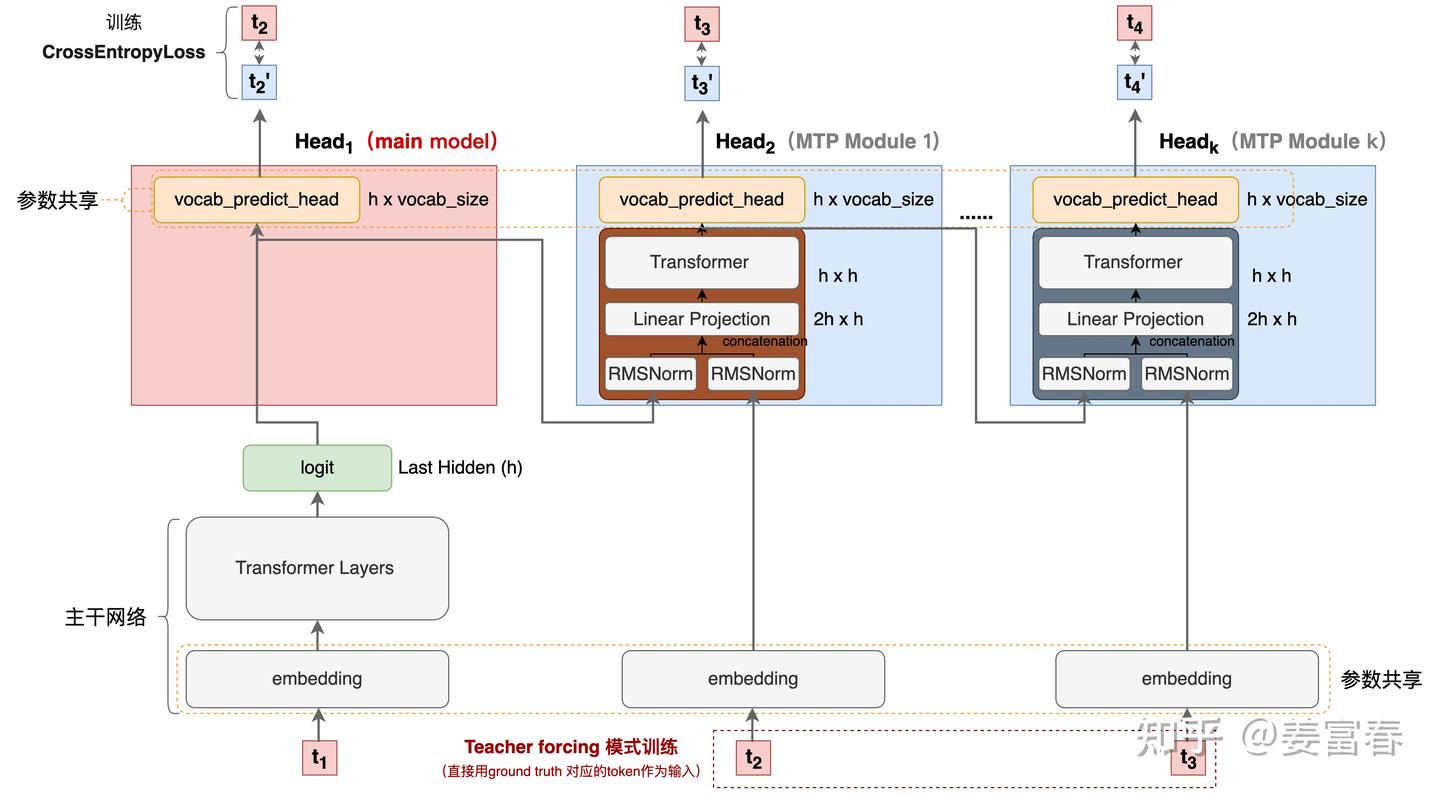
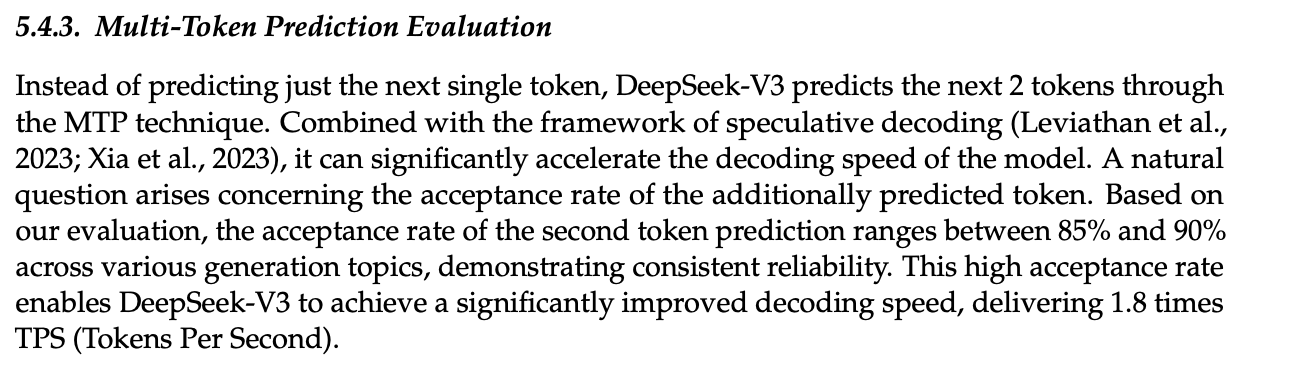
DeepSeek V3中强调,MTP的设计主要是为了训练过程能加速收敛,更充分的使用训练样本。所以针对推理阶段只是简单介绍了一段。
DeepSeek V3推理可以有两种方法:
方法1:直接把MTP Model头全部删掉,模型变成了一个Predict Next Token的 Main Model。然后部署模型做推理,这个就跟正常LLM模型推理一样。没有什么加速效果
方法2:保留MTP Model 做self-speculative decoding,这样充分使用多Head预测能力,提升推理加速性能。
V3的技术报告明确表示 V3 开启MTP时第二个token的接受率可以到85-90%。TPS可以实现1.8倍加速。
MTP的使用
只要基座模型的开源权重中自带了预训练好的 MTP 层(如 DeepSeek-V3/R1、Qwen3-Next / Qwen3.8-Flash-Next、GLM-5、Step-3.5-Flash 等),在启动 vLLM 或 SGLang 时只需加上一行配置参数,推理引擎就会自动加载模型内部的 MTP 层并激活自投机解码。
示例
vllm:
vllm serve Qwen/Qwen3.8-Flash-Next \
  --tensor-parallel-size 8 \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 3}'
Sglang:
python3 -m sglang.launch_server \
  --model-path deepseek-ai/DeepSeek-V3 \
  --tp 8 \
  --speculative-algo NEXTN \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4
MTP的缺点
小规模模型与传统 NLP 选择题上的性能退化
MTP 强迫主干网络的隐状态同时编码未来多个位置的精确词汇信息。当模型参数规模较小,或者任务本身不需要长程规划时,这种强制性的远期预测目标反而会分散主干网络对Next Token局部精确概率的拟合能力
预测步数超参数极度敏感
预训练时将 MTP 深度 $n$ 设得过大,远期预测头会产生居高不下的交叉熵损失
存储与通信开销
(1)DeepSeek-V3 主模型为 671B,而仅仅 1 层 MTP 模块(因其内部同样包含庞大的 MoE 路由专家层)就重达 14B 参数
(2)顺序因果链 MTP 必须同时访问主模型最底部的词嵌入层和最顶部的输出层。在大规模跨节点流水线并行训练中,首层和末层往往位于不同的 GPU 节点上。要实现物理权重共享而不产生巨大的通信等待气泡,必须像 DeepSeek 的 DualPipe 那样定制极其复杂的双向流水线调度系统。
高并发推理下加速收益消失
在推理阶段开启 MTP 自投机解码时,它本质上是用冗余算力换取延迟降低。这一机制在低并发下效果极佳,但在高并发满载生产环境中会遇到算力瓶颈。
高采样温度草稿命中率低
MTP 投机加速的上限高度依赖生成文本的可预测性。高采样温度概率分布趋于平缓,随机采样带来的分支极多。仅由 1 层 Transformer 构成的 MTP 模块很难猜中主模型随机采样的结果,接受率会明显下滑,加速效果随之大幅缩水。
MTP现状
截至 2026 年 10 月,工业界主流开源与商业大模型(如 DeepSeek-V3 系列、Qwen3-Next / Qwen3.8-Flash-Next、GLM-5、Step-3.5-Flash、NVIDIA Nemotron 3 Super 等)所采用的原生 MTP,已经全面转向以 DeepSeek-V3 为代表的“顺序因果链结构,基本淘汰了早期 Meta(提出的“独立并行多头结构
各大厂商在继承 DeepSeek-V3 顺序因果链结构的基础上,针对推理吞吐量和显存开销做了三项标准化改进:
单模块递归复用
在预训练时挂载多个独立的 MTP 层会增加模型权重体积和流水线通信负载。因此,当前主流模型倾向于只保留 1 个 MTP 模块或采用跨深度权重共享,在推理时像循环神经网络一样自己调自己来生成多步草稿。https://developers.redhat.com/articles/2026/09/08/optimize-vllm-speculative-decoding-fastmtp-heads#get_started_with_speculators_0_6_0
这样做的目的主要是为了 在不增加额外参数体积的前提下实现多步连续投机。
与 EAGLE 算法栈彻底合流
DeepSeek-V3 在报告中明确指出其因果链设计与投机解码算法 EAGLE 原理相通(多步推理时,当前head的输入都有上一层的隐藏层特征)。因此到了 2025—2026 年,vLLM、SGLang 等主流推理框架直接将原生 MTP 纳入了 EAGLE 的执行管线中。区别仅在于:EAGLE 是后训练阶段外挂上去的草稿头,而 DeepSeek-V3 / Qwen3-Next 的 MTP 是在预训练阶段就与主干一起协同进化的“原生 EAGLE 头”
稀疏注意力索引复用
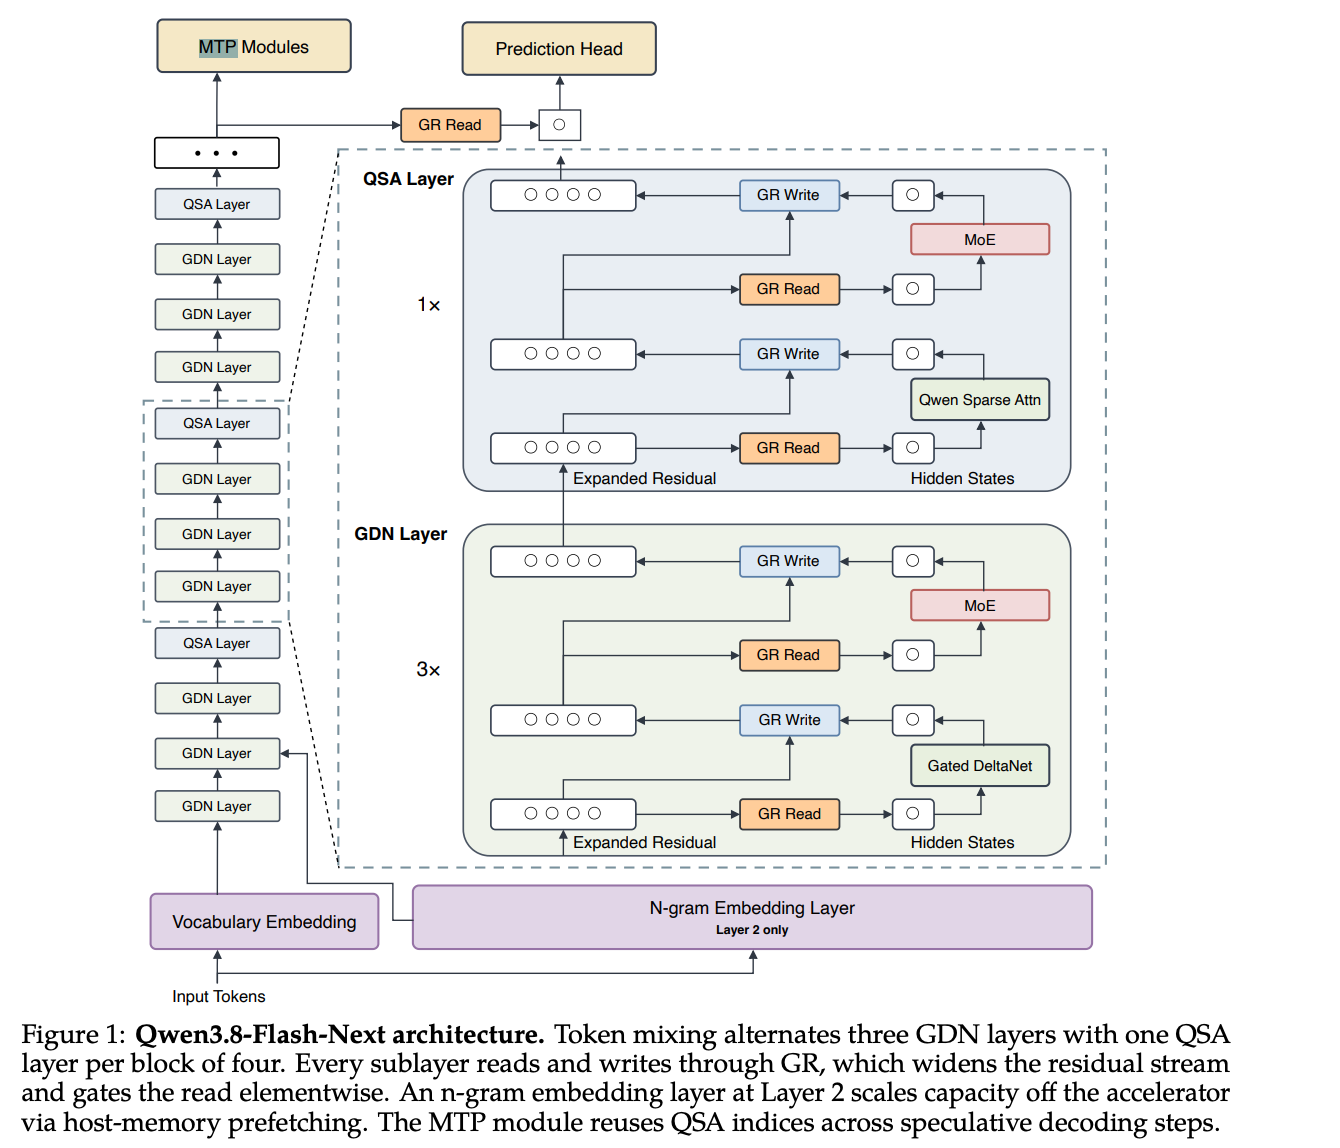
在 2026 年最新的混合线性/稀疏注意力架构(如 Qwen3.8-Flash-Next、GLM-5)中,为了防止 MTP 模块在长文本下计算注意力时成为新的延迟瓶颈,引入了跨步索引复用机制 https://arxiv.org/pdf/2608.30320
也就是说 MTP 模块不再自己重新检索整个 KV Cache,而是直接复用主干网络选出的 Top-$k$ 索引,使长文本下的投机草稿生成开销进一步大幅下降。
参考资料
(1)https://arxiv.org/pdf/2404.19737
(2)https://arxiv.org/pdf/2401.10774
(3)https://zhuanlan.zhihu.com/p/15037286337
(4)https://zhuanlan.zhihu.com/p/1947349001578997723
(5)https://sebastianraschka.com/llm-architecture-gallery/mtp/#:~:text=The%20original%20study%20found%20that%20predicting%20four,the%20model%20learns%20two%20targets%20per%20position.
(6)https://arxiv.org/pdf/2608.30320